Warum die Weiterentwicklung von BIRD auch für die künftige Nutzung von Large Language Models interessant ist.
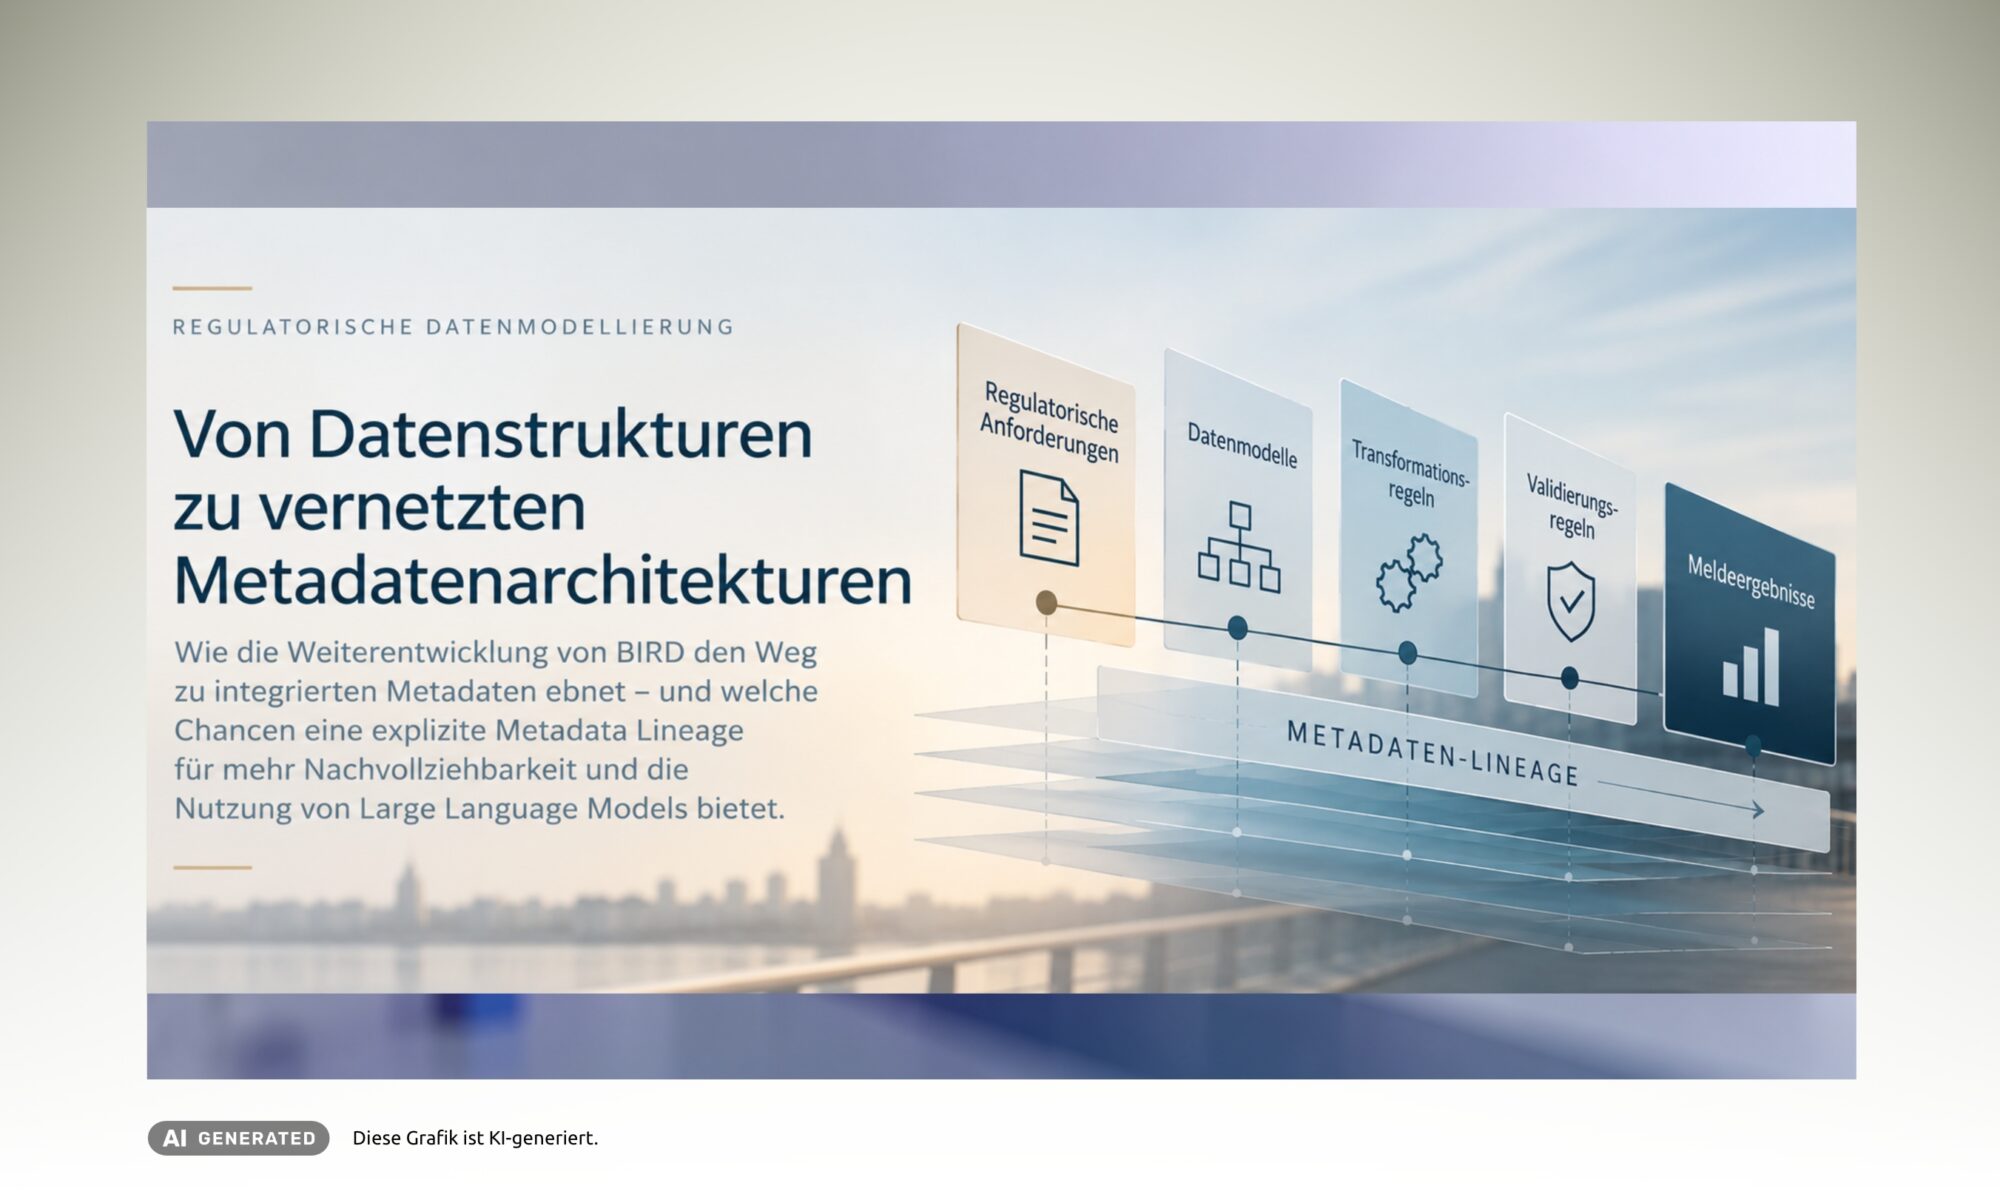
Die regulatorische Datenmodellierung befindet sich in einer Entwicklung, die über die klassische Beschreibung von Datenstrukturen hinausgeht. Zunehmend rücken integrierte Metadatenarchitekturen in den Mittelpunkt, in denen Datenmodelle, fachliche Definitionen, Transformationsregeln und Validierungsanforderungen miteinander verbunden werden.
Ein aktuelles Beispiel hierfür ist die angekündigte Weiterentwicklung des Banks’ Integrated Reporting Dictionary (BIRD) der Europäischen Zentralbank (EZB). Für November 2026 wurden unter anderem ein weiterentwickeltes methodisches Rahmenwerk sowie erweiterte Möglichkeiten zur Abbildung von Metadata Lineage angekündigt.
Diese Entwicklung ist nicht allein aus Sicht der regulatorischen Datenmodellierung interessant. Sie eröffnet auch Perspektiven für eine strukturierte, nachvollziehbare Nutzung regulatorischer Informationen durch KI-Systeme.
Von isolierten Datenstrukturen zu vernetzten Informationen
Regulatorische Datenmodelle beschreiben nicht nur Datenfelder, Datentypen und zulässige Werte. Für das fachliche Verständnis sind ebenso die Beziehungen zwischen Daten, Definitionen, regulatorischen Anforderungen und Verarbeitungsregeln relevant.
Eine integrierte Metadatenarchitektur kann diese Zusammenhänge explizit abbilden.
Damit entsteht die Möglichkeit, Informationen nicht ausschließlich als einzelne Datenobjekte zu betrachten, sondern sie innerhalb ihres fachlichen und technischen Kontextes nachzuvollziehen.
Besonders relevant ist dabei die Metadata Lineage: Sie beschreibt die Herkunft, Verarbeitung und Abhängigkeiten von Daten beziehungsweise Metadaten über verschiedene Ebenen hinweg.
Werden diese Zusammenhänge zusätzlich versioniert, lassen sich auch Veränderungen von Definitionen, Zuordnungen und Regeln über die Zeit nachvollziehen.
Metadata Lineage als Grundlage für nachvollziehbare KI-Nutzung
Für den Einsatz von Large Language Models (LLMs) im regulatorischen Umfeld verbinde ich damit eine grundlegende Frage:
Wie lässt sich sicherstellen, dass eine fachliche Aussage nicht nur plausibel formuliert ist, sondern auch auf nachvollziehbaren regulatorischen Informationen beruht?
Die Qualität einer KI-generierten Antwort hängt nicht allein von der Leistungsfähigkeit des verwendeten Sprachmodells ab. Entscheidend sind ebenso die Qualität, Struktur und Verknüpfung der verfügbaren Informationsgrundlagen.
Explizite Beziehungen zwischen regulatorischen Anforderungen, fachlichen Definitionen, Datenmodellen und Regeln helfen dabei, den Kontext einer Aussage genauer zu bestimmen.
Eine versionierte Metadata Lineage könnte darüber hinaus unterstützen, die für eine Aussage relevanten Informationsstände und Abhängigkeiten zu identifizieren.
Das bedeutet allerdings nicht, dass vernetzte Metadaten bereits eine verlässliche KI-Anwendung gewährleisten. Die fachliche Richtigkeit der Informationen, ihre regulatorische Gültigkeit und die belastbare Zuordnung zu Primärquellen bleiben eigenständige Anforderungen.
Metadata Lineage kann die Nachvollziehbarkeit von Evidenz verbessern – sie ersetzt jedoch nicht deren fachliche Verifikation.
Eine interessante Entwicklungsrichtung
Die angekündigten BIRD-Erweiterungen sind ein weiteres Indiz dafür, dass sich regulatorische Datenmodellierung zunehmend in Richtung integrierter, vernetzter Metadatenarchitekturen entwickelt.
Wie weit diese Möglichkeiten in der konkreten technischen Umsetzung reichen, wird sich anhand der veröffentlichten Spezifikationen beurteilen lassen.
Unabhängig davon zeichnet sich eine Perspektive ab: Regulatorische Metadaten könnten künftig nicht nur die Grundlage für Datenintegration, Transformation und Validierung bilden, sondern auch eine wichtige Rolle bei der evidenzbasierten Nutzung von Large Language Models übernehmen.
Damit gewinnt die strukturierte Modellierung regulatorischer Zusammenhänge eine zusätzliche Bedeutung – über die klassischen Aufgaben des Meldewesens hinaus.
Die Inhalte dieses Beitrages wurden mit angemessener Sorgfalt erstellt. Für die Richtigkeit, Vollständigkeit und Aktualität der Inhalte übernehmen wir keine Gewähr und diese sind in keiner Weise als Angebot oder Empfehlung bestimmter Vorgehensweisen oder Beratungsinhalte zu verstehen, sondern spiegeln vielmehr die persönlichen Einschätzungen und Erkenntnisse der jeweiligen Autorin oder des jeweiligen Autors in Bezug auf die hier angeführten Sachverhalte wider. Wir bitten Sie, eine weitere Verwendung nur im Falle unserer ausdrücklichen separat zu erteilenden schriftlichen Zustimmung in Betracht zu ziehen. Kommen Sie gerne auf uns zu.